SpaceXAI запускает Grok 4.7 для программирования и интеллектуальной работы
SpaceXAI выпустила модель Grok 4.7, назвав её своей самой эффективной моделью для написания кода и интеллектуальной работы. Она дольше работает над сложными задачами и тщательнее перепроверяет результаты своего труда.
По информации SpaceXAI, новая модель уже доступна в Cursor и Grok Build, а также через Grok API, сторонние среды для программирования, маршрутизаторы моделей и облачные платформы. Цены начинаются с $2 за миллион входных токенов и $6 за миллион выходных токенов, что соответствует показателям Grok 4.6 в сравнительной таблице и при этом ниже расценок на ввод и вывод для GPT-5.6 Sol и Fable 5.1. Также доступен быстрый вариант модели с удвоенной скоростью генерации по удвоенной цене.
В основе новинки лежит новая, более крупная базовая модель по сравнению с предшественницей. Она прошла обучение в рамках более длительного цикла обучения с подкреплением на более сложном наборе данных с упором на многочасовые задачи. Модель лучше справляется с проверкой собственной работы и управлением большими контекстами, а также обладает встроенным пониманием среды Grok Bot для решения разговорных задач и общих задач по работе с информацией. Что касается работы с документами и презентациями, в анонсе отмечается рост показателей в бенчмарках GDPval и AA Briefcase — в последнем результат вырос с 1 546 до 1 657, лишь немного не дотянув до 1 678 у Fable 5.1.
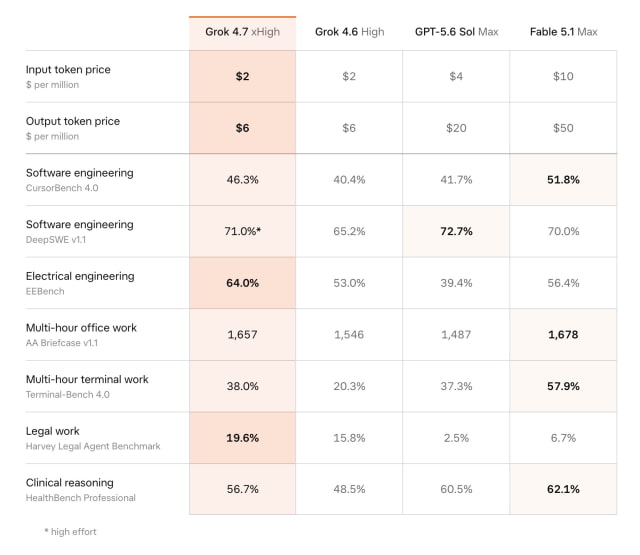
В тестах CursorBench 4.0, ориентированных на длительные задачи по программированию, Grok 4.7 набирает 46,3% (по сравнению с 40,4% у Grok 4.6), опережая GPT-5.6 Sol с его 41.7%, но уступая Fable 5.1, у которой этот показатель равен 51,8%. Кроме того, модель показывает 64,0% в EEBench и 19,6% в юридическом бенчмарке Harvey, опережая в обоих случаях три другие модели из таблицы. В то же время в Terminal-Bench лидирует Fable 5.1 с результатом 57,9% против 38,0% у Grok 4.7 (который, впрочем, улучшил прошлогодний результат Grok 4.6, составлявший 20,3%).
Grok 4.7 позиционируется как самая устойчивая к отказам и попыткам обхода защиты модель из всех, что тестировала компания: она создана на базе принципиально нового стека защитных механизмов. Согласно анонсу, она занимает первое место в биобезопасном бенчмарке LatchBio с результатом 62,4% и пропускает лишь 3,3% рискованных промптов двойного назначения в HackerBench v0.3, сохраняя при этом низкий процент ложных отказов при выполнении легитимных задач по обеспечению безопасности. Избранные партнеры в сфере кибербезопасности получают доступ по приглашениям к возможностям поиска уязвимостей (red-teaming) для оборонных исследований.